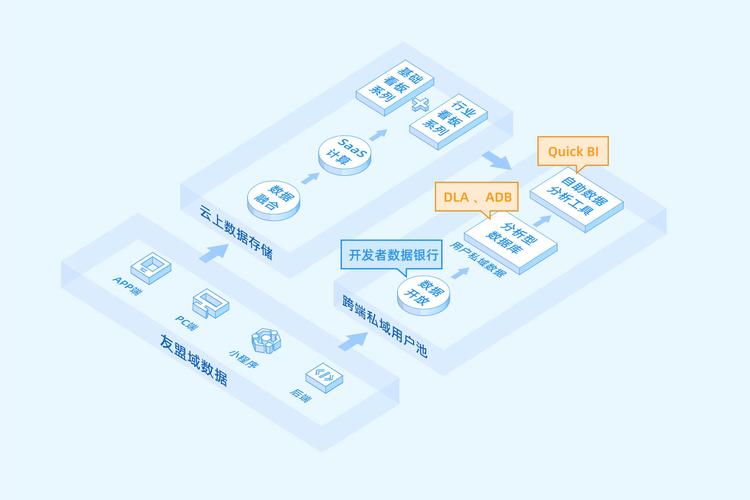
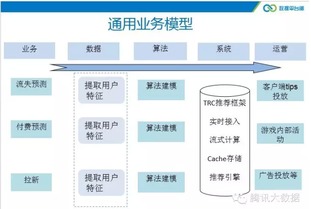
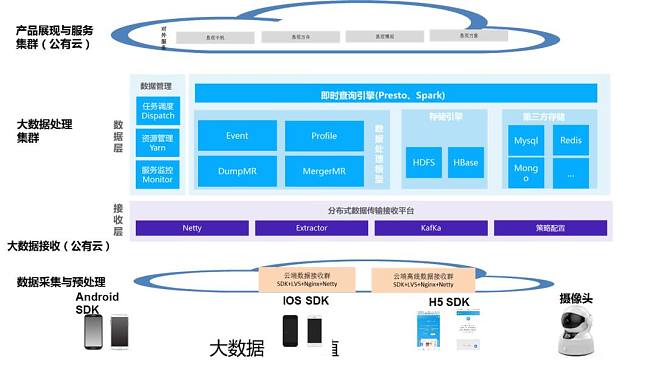
大數據架構圖是展示大數據系統組件及其相互關系的可視化工具,通常包括數據采集、存儲、計算、分析和服務等層次。在設計新一代數據處理服務時,理解架構圖的關鍵點至關重要。\n\n數據采集層是架構圖的起點,常見組件有日志收集器(如Flume或Fluentd)和消息隊列(Kafka、RabbitMQ),它們負責接收來自不同來源的數據流,并確保高可靠性和低延遲。這一層處理的數據可能是原始日志文件、API調用或物聯網設備發送的數據。\n\n緊接著,數據存儲層處理文件或對象存儲,如HDFS、Amazon S3或云盤。對于關系型數據,可以使用分布式數據庫,如Elasticsearch用于搜索驅動的大數據,而其結構化解決方案如Columnar存儲(Parquet)有助于傳輸效率。以靈活性和可靠性的選擇為主。處理后的數據流向服務層并分配給ML推導或用戶交互的項目后端,常常無結構的示例數據有記錄反饋閉環分析的基礎奠定潛力模塊最終維持自動重新分布式緩存高性能模型進行持續學習滾動后配置去批量異構離線支持的定制方式。
大數據架構圖解讀 如何構建高效的數據處理服務
如若轉載,請注明出處:http://m.metatrader4.net.cn/product/87.html
更新時間:2026-10-01 20:34:03